
Quy trình sử dụng Screaming Frog kiểm tra Technical SEO
Mục lục
- Screaming Frog là gì và vai trò trong Technical SEO
- Chuẩn bị trước khi sử dụng Screaming Frog kiểm tra website
- Cách thiết lập Screaming Frog trước khi crawl
- Quy trình crawl website bằng Screaming Frog
- Kiểm tra lỗi Technical SEO bằng Screaming Frog
- Phân tích liên kết nội bộ bằng Screaming Frog
- Kiểm tra hình ảnh và tài nguyên website
- Kiểm tra Sitemap và Robots.txt bằng Screaming Frog
- Cách ưu tiên xử lý lỗi sau khi audit bằng Screaming Frog
- Những sai lầm thường gặp khi sử dụng Screaming Frog
- Quy trình Screaming Frog Technical SEO audit hoàn chỉnh
- Lợi ích khi sử dụng Screaming Frog trong Technical SEO
Quy trình sử dụng Screaming Frog kiểm tra Technical SEO giúp SEOer thu thập dữ liệu website, phân tích cấu trúc, phát hiện lỗi kỹ thuật và tối ưu khả năng thu thập dữ liệu của công cụ tìm kiếm
Screaming Frog SEO Spider là công cụ thu thập dữ liệu website mô phỏng cách bot tìm kiếm truy cập và phân tích các URL. Trong Technical SEO, công cụ này được sử dụng để kiểm tra khả năng crawl, phát hiện lỗi trạng thái HTTP, phân tích thẻ HTML, kiểm tra liên kết nội bộ, đánh giá sitemap, robots.txt và nhiều yếu tố kỹ thuật ảnh hưởng đến khả năng lập chỉ mục
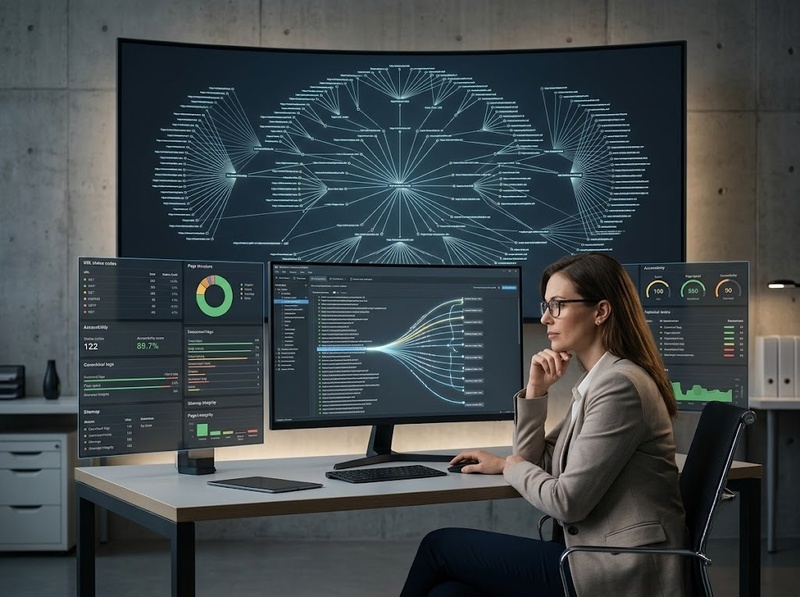
Quy trình sử dụng Screaming Frog hiệu quả không chỉ dừng ở việc chạy crawl toàn bộ website mà cần bao gồm các bước thiết lập cấu hình, phân tích dữ liệu thu thập được, xác định vấn đề ưu tiên và đưa ra hướng xử lý phù hợp
Screaming Frog là gì và vai trò trong Technical SEO
Screaming Frog SEO Spider là một crawler hỗ trợ SEO kỹ thuật bằng cách thu thập dữ liệu các URL trên website theo cách tương tự bot của công cụ tìm kiếm
Công cụ này giúp SEOer trả lời các câu hỏi quan trọng trong quá trình kiểm tra Technical SEO:
· Website có bao nhiêu URL đang tồn tại
· Công cụ tìm kiếm có thể truy cập các trang quan trọng hay không
· Có URL bị lỗi 4xx hoặc 5xx hay không
· Có trang bị trùng lặp nội dung hoặc thiếu thẻ SEO quan trọng hay không
· Cấu trúc liên kết nội bộ có hỗ trợ phân phối sức mạnh SEO hay không
· Sitemap và robots.txt có đang được cấu hình đúng hay không
Screaming Frog đặc biệt hữu ích khi kiểm tra website lớn, website sau khi migration, website gặp vấn đề index hoặc cần audit Technical SEO định kỳ
Chuẩn bị trước khi sử dụng Screaming Frog kiểm tra website
Trước khi bắt đầu crawl, cần xác định mục tiêu kiểm tra để lựa chọn cấu hình phù hợp
Một số mục tiêu phổ biến:
· Audit toàn bộ Technical SEO của website
· Kiểm tra lỗi sau khi thay đổi cấu trúc URL
· Phân tích website đối thủ
· Kiểm tra tình trạng index
· Tìm lỗi ảnh hưởng đến trải nghiệm người dùng
Ngoài ra cần chuẩn bị:
· URL chính xác của website cần kiểm tra
· Quyền truy cập Google Analytics hoặc Google Search Console nếu cần kết hợp dữ liệu
· Danh sách các khu vực quan trọng như landing page, category page, product page
Cách thiết lập Screaming Frog trước khi crawl
Cấu hình chế độ crawl phù hợp
Screaming Frog cung cấp nhiều chế độ thu thập dữ liệu:
· Spider Mode: Crawl website trực tiếp thông qua liên kết nội bộ
· List Mode: Crawl danh sách URL có sẵn
· SERP Mode: Phân tích dữ liệu tiêu đề và meta description
· Compare Mode: So sánh dữ liệu giữa các lần crawl
Đối với Technical SEO audit thông thường, Spider Mode là lựa chọn phổ biến nhất
Cấu hình phạm vi thu thập dữ liệu
Trước khi crawl cần kiểm tra:
· Domain có đúng phiên bản HTTPS hay không
· Có cần crawl subdomain hay không
· Có muốn loại trừ thư mục nhất định hay không
· Có cần giới hạn số lượng URL hay không
Việc cấu hình đúng giúp tránh thu thập dữ liệu ngoài phạm vi cần phân tích
Quy trình crawl website bằng Screaming Frog
Sau khi nhập URL website vào Screaming Frog, quá trình crawl sẽ thu thập các dữ liệu chính:
· URL
· Status code
· Page title
· Meta description
· Heading
· Canonical URL
· Robots directive
· Internal link
· External link
· Image
· Response time
Quy trình cơ bản:
1. Nhập URL website vào Screaming Frog
2. Chọn chế độ crawl phù hợp
3. Bắt đầu thu thập dữ liệu
4. Theo dõi số lượng URL được crawl
5. Chờ crawler hoàn thành
6. Xuất dữ liệu để phân tích
Sau khi crawl hoàn tất, dữ liệu thu được cần được phân loại theo mức độ ảnh hưởng thay vì xử lý ngẫu nhiên
Kiểm tra lỗi Technical SEO bằng Screaming Frog
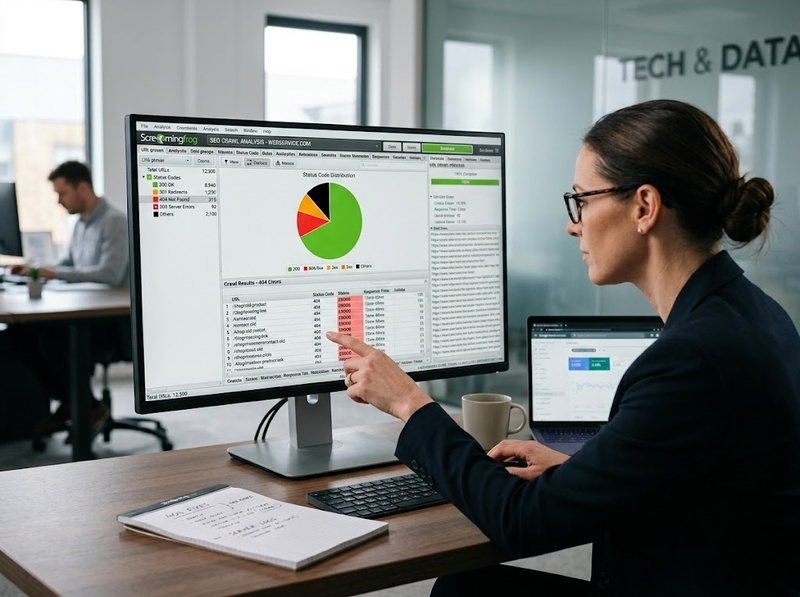
Phân tích lỗi HTTP Status Code
Status Code cho biết tình trạng phản hồi của URL
Các nhóm lỗi thường gặp:
· 200 OK: URL hoạt động bình thường
· 3xx: URL chuyển hướng
· 4xx: URL không tồn tại hoặc bị lỗi truy cập
· 5xx: Lỗi từ máy chủ
Các vấn đề cần ưu tiên:
· URL quan trọng trả về lỗi 404
· Chuỗi redirect quá dài
· Redirect loop
· URL trả về lỗi server
Những lỗi này có thể ảnh hưởng đến khả năng crawl và trải nghiệm người dùng
Kiểm tra Title và Meta Description
Trong tab Page Titles và Meta Description có thể phát hiện:
· Thiếu title
· Trùng title
· Title quá dài
· Meta description bị thiếu
· Meta description trùng lặp
Các yếu tố này ảnh hưởng đến khả năng hiểu nội dung trang và khả năng hiển thị trên kết quả tìm kiếm
Kiểm tra Heading Structure
Screaming Frog giúp kiểm tra:
· Trang thiếu H1
· Trang có nhiều H1
· H1 bị trùng lặp
· Cấu trúc heading không hợp lý
Heading cần phản ánh cấu trúc nội dung để hỗ trợ cả người dùng và công cụ tìm kiếm hiểu chủ đề trang
Kiểm tra Canonical URL
Canonical giúp xác định phiên bản URL chính khi website có nhiều phiên bản nội dung tương tự
Cần kiểm tra:
· URL có canonical hay không
· Canonical có trỏ sai địa chỉ không
· Canonical có trỏ đến trang lỗi hay không
· Canonical có gây xung đột với robots hoặc index directive không
Phân tích liên kết nội bộ bằng Screaming Frog
Liên kết nội bộ ảnh hưởng đến khả năng crawl và phân phối giá trị SEO giữa các trang
Screaming Frog hỗ trợ phân tích:
· Số lượng internal link trỏ đến mỗi URL
· Trang không có internal link
· Trang quan trọng nhưng ít được liên kết
· Trang có quá nhiều liên kết nội bộ
Một số vấn đề thường gặp:
· Orphan page: Trang tồn tại nhưng không có liên kết nội bộ
· Deep page: Trang nằm quá sâu trong cấu trúc website
· Internal link trỏ đến URL redirect hoặc lỗi
Việc tối ưu internal link giúp bot tìm thấy nội dung quan trọng dễ dàng hơn
Kiểm tra hình ảnh và tài nguyên website
Screaming Frog có thể phát hiện các vấn đề liên quan đến hình ảnh:
· Ảnh dung lượng lớn
· Thiếu thuộc tính alt
· URL ảnh lỗi
· Ảnh không được tối ưu
Các vấn đề này ảnh hưởng đến tốc độ tải trang và khả năng tiếp cận nội dung
Kiểm tra Sitemap và Robots.txt bằng Screaming Frog
Phân tích Sitemap
Sitemap cần đảm bảo:
· Chỉ chứa URL hợp lệ
· Không chứa URL lỗi
· Không chứa trang redirect
· Không chứa trang bị chặn index
Screaming Frog có thể giúp so sánh URL trong sitemap với dữ liệu crawl thực tế
Kiểm tra Robots.txt
Robots.txt quyết định khu vực crawler được phép hoặc không được phép truy cập
Cần kiểm tra:
· Có chặn nhầm trang quan trọng không
· Có khai báo sitemap đúng không
· Có rule gây ảnh hưởng đến crawl không
Cách ưu tiên xử lý lỗi sau khi audit bằng Screaming Frog
Không phải lỗi nào phát hiện được cũng có mức độ ảnh hưởng giống nhau
Có thể ưu tiên theo thứ tự:
1. Lỗi khiến công cụ tìm kiếm không truy cập được nội dung quan trọng
Ví dụ:
· Server error
· Trang bị chặn crawl
· URL quan trọng trả về 404
2. Lỗi ảnh hưởng đến khả năng index
Ví dụ:
· Canonical sai
· Noindex không đúng mục đích
· Sitemap chứa URL không hợp lệ
3. Lỗi ảnh hưởng đến chất lượng tối ưu SEO
Ví dụ:
· Thiếu title
· Thiếu meta description
· Internal link chưa tối ưu
4. Lỗi tối ưu trải nghiệm
Ví dụ:
· Ảnh lớn
· Tài nguyên tải chậm
Những sai lầm thường gặp khi sử dụng Screaming Frog
Chỉ crawl website nhưng không phân tích dữ liệu
Việc chạy crawl chỉ tạo ra dữ liệu thô. Giá trị thực tế nằm ở việc xác định lỗi nào ảnh hưởng đến SEO và cách xử lý
Xử lý tất cả lỗi với mức ưu tiên giống nhau
Một lỗi nhỏ về meta description không có cùng mức ảnh hưởng với lỗi khiến hàng nghìn URL không được crawl
Không cấu hình trước khi crawl
Crawl sai phạm vi có thể tạo dữ liệu nhiễu và làm mất thời gian phân tích
Không kết hợp dữ liệu từ nguồn khác
Screaming Frog nên được kết hợp với dữ liệu từ Google Search Console, Analytics hoặc log server khi cần phân tích chuyên sâu hơn
Quy trình Screaming Frog Technical SEO audit hoàn chỉnh
Một quy trình thực tế có thể triển khai theo các bước:
1. Xác định mục tiêu audit
2. Cấu hình Screaming Frog theo phạm vi website
3. Crawl toàn bộ website
4. Kiểm tra URL status code
5. Phân tích title, meta description, heading
6. Kiểm tra canonical và robots directive
7. Phân tích internal link
8. Kiểm tra sitemap và robots.txt
9. Xuất dữ liệu báo cáo
10. Xây dựng danh sách lỗi theo mức độ ưu tiên
11. Triển khai sửa lỗi
12. Crawl lại để xác nhận kết quả
Quy trình này giúp biến dữ liệu crawl thành kế hoạch cải thiện Technical SEO có thể đo lường
Lợi ích khi sử dụng Screaming Frog trong Technical SEO
Screaming Frog giúp SEOer:
· Tiết kiệm thời gian kiểm tra website thủ công
· Phát hiện lỗi kỹ thuật trên quy mô lớn
· Hiểu cấu trúc website thực tế
· Kiểm soát khả năng crawl của công cụ tìm kiếm
· Hỗ trợ quá trình migration hoặc redesign website
· Tạo báo cáo audit có hệ thống
Tuy nhiên, Screaming Frog chỉ là công cụ thu thập và phân tích dữ liệu. Việc quyết định lỗi nào cần xử lý vẫn cần dựa trên mục tiêu SEO, cấu trúc website và chiến lược nội dung
Screaming Frog là một trong những công cụ quan trọng để thực hiện Technical SEO audit vì khả năng mô phỏng quá trình crawl của công cụ tìm kiếm và phát hiện các vấn đề kỹ thuật trên toàn bộ website
Quy trình sử dụng hiệu quả cần bắt đầu từ việc xác định mục tiêu, cấu hình crawl đúng cách, phân tích dữ liệu theo mức độ ưu tiên và kiểm tra lại sau khi tối ưu
Khi được sử dụng đúng phương pháp, Screaming Frog không chỉ giúp tìm lỗi mà còn cung cấp góc nhìn toàn diện về khả năng thu thập dữ liệu, cấu trúc website và các yếu tố ảnh hưởng đến hiệu quả SEO
Hỏi đáp về hướng dẫn sử dụng Screaming Frog
Screaming Frog dùng để làm gì trong SEO?
Screaming Frog được sử dụng để crawl website và phát hiện các vấn đề Technical SEO như lỗi HTTP, lỗi metadata, vấn đề internal link, canonical, sitemap và khả năng index
Screaming Frog có phù hợp với website lớn không?
Có. Screaming Frog được thiết kế để phân tích website từ nhỏ đến lớn, tuy nhiên website càng lớn càng cần cấu hình crawl, bộ nhớ và phạm vi kiểm tra phù hợp
Bao lâu nên kiểm tra Technical SEO bằng Screaming Frog?
Tần suất phụ thuộc vào quy mô và mức độ thay đổi của website. Website lớn hoặc thường xuyên cập nhật có thể cần audit định kỳ, trong khi website nhỏ có thể kiểm tra sau các thay đổi quan trọng
Screaming Frog có thay thế Google Search Console không?
Không. Screaming Frog và Google Search Console cung cấp dữ liệu khác nhau. Screaming Frog tập trung vào crawl và cấu trúc website, trong khi Google Search Console cung cấp dữ liệu từ hệ thống tìm kiếm của Google như hiệu suất và trạng thái index

GỬI Ý KIẾN BÌNH LUẬN
