
Tiêu chí đánh giá độ tin cậy của dữ liệu Marketing
Mục lục
- Độ tin cậy của dữ liệu Marketing là gì?
- Đánh giá nguồn gốc và khả năng truy vết dữ liệu
- Kiểm tra độ chính xác của dữ liệu
- Đo lường tính đầy đủ của dữ liệu
- Xác minh tính nhất quán giữa các hệ thống
- Đánh giá tính cập nhật và độ trễ
- Kiểm tra tính duy nhất và quản trị định danh
- Đánh giá tính đại diện của dữ liệu
- Xác định dữ liệu có phù hợp với mục tiêu phân tích hay không
- Kiểm tra sai lệch trong quá trình thu thập và đo lường
- Đánh giá độ ổn định và khả năng tái lập kết quả
- Sử dụng bảng điểm để lượng hóa mức độ tin cậy
- Quy trình kiểm tra dữ liệu trước khi phân tích
- Những dấu hiệu cho thấy dữ liệu chưa đủ tin cậy
- Phân biệt dữ liệu sạch với dữ liệu đáng tin cậy
Hướng dẫn đánh giá độ tin cậy của dữ liệu Marketing dựa trên nguồn gốc, độ chính xác, tính đầy đủ, nhất quán, cập nhật, đại diện và khả năng truy vết trước khi đưa ra kết luận.
Dữ liệu Marketing đáng tin cậy không đơn thuần là dữ liệu có nhiều bản ghi hoặc được lấy từ một nền tảng phổ biến. Độ tin cậy phản ánh mức độ dữ liệu có thể được sử dụng để mô tả đúng hành vi khách hàng, so sánh hiệu quả chiến dịch và hỗ trợ quyết định mà không tạo ra sai lệch nghiêm trọng.
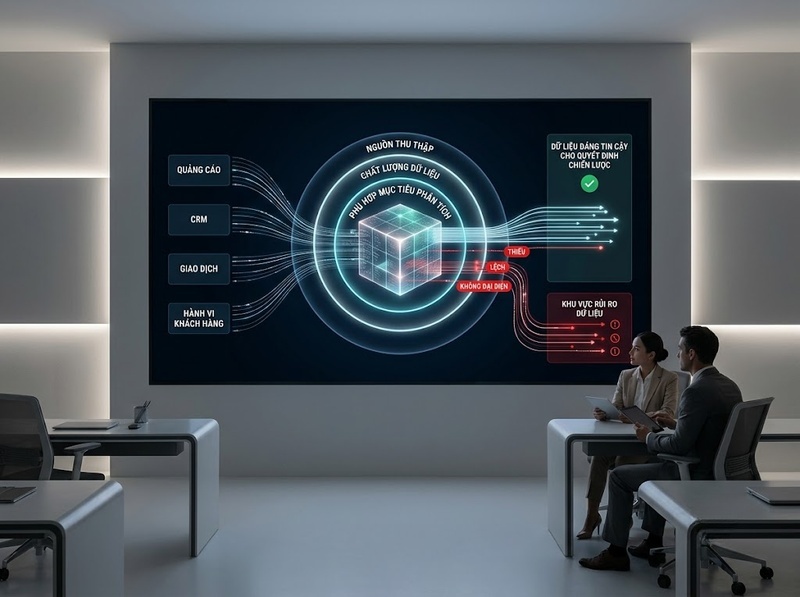
Việc đánh giá cần được thực hiện theo ba lớp: kiểm tra nguồn và quá trình thu thập, đo chất lượng của tập dữ liệu, sau đó xác minh dữ liệu có phù hợp với câu hỏi phân tích hay không. Một tập dữ liệu có thể chính xác về mặt kỹ thuật nhưng vẫn không đáng tin cho một quyết định cụ thể nếu sai đối tượng, sai thời điểm hoặc thiếu khả năng đại diện.
Độ tin cậy của dữ liệu Marketing là gì?
Độ tin cậy của dữ liệu Marketing là mức độ dữ liệu phản ánh ổn định, chính xác và có thể kiểm chứng đối tượng hoặc hiện tượng mà doanh nghiệp muốn phân tích.
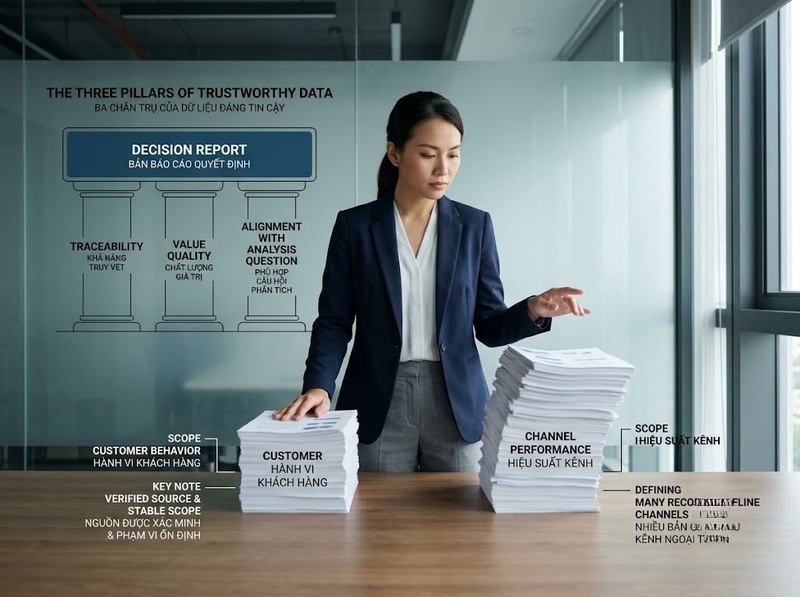
Một tập dữ liệu đáng tin cậy cần đáp ứng đồng thời ba điều kiện:
· Dữ liệu được thu thập bằng phương pháp rõ ràng và có thể truy vết
· Các giá trị trong dữ liệu đủ chính xác, đầy đủ, nhất quán và cập nhật
· Dữ liệu phù hợp với khách hàng, kênh, thời gian và mục tiêu phân tích
Ba điều kiện này không thể thay thế cho nhau. Chẳng hạn, dữ liệu quảng cáo có thể được ghi nhận chính xác trong nền tảng nhưng không đại diện đầy đủ cho doanh thu nếu hệ thống chưa kết nối dữ liệu bán hàng ngoại tuyến. Ngược lại, dữ liệu CRM có thể bao phủ gần như toàn bộ khách hàng nhưng vẫn tạo kết luận sai nếu nhiều hồ sơ trùng lặp hoặc trạng thái khách hàng không được cập nhật.
Vì vậy, độ tin cậy không phải thuộc tính tuyệt đối. Dữ liệu chỉ có thể được xem là đủ tin cậy trong một phạm vi sử dụng xác định.
Đánh giá nguồn gốc và khả năng truy vết dữ liệu
Nguồn gốc dữ liệu là tiêu chí đầu tiên cần kiểm tra vì nó quyết định doanh nghiệp có thể giải thích dữ liệu được tạo ra như thế nào hay không.
Một nguồn dữ liệu có khả năng truy vết cần trả lời được các câu hỏi:
· Dữ liệu đến từ hệ thống nào
· Sự kiện hoặc thuộc tính được ghi nhận theo định nghĩa nào
· Ai là người hoặc hệ thống tạo dữ liệu
· Dữ liệu được thu thập vào thời điểm nào
· Những bước xử lý nào đã được áp dụng
· Dữ liệu đã được kết hợp với nguồn nào khác
Dữ liệu bên thứ nhất như giao dịch, CRM, lịch sử sử dụng sản phẩm hoặc hành vi trên tài sản số của doanh nghiệp thường có khả năng kiểm soát cao hơn vì doanh nghiệp biết rõ cách dữ liệu được tạo ra. Tuy nhiên, nguồn bên thứ nhất không mặc nhiên đáng tin cậy. Cấu hình theo dõi sai, sự kiện bị gửi lặp, nhân viên nhập liệu không thống nhất hoặc thiếu quản trị định danh vẫn có thể làm giảm chất lượng.
Với dữ liệu từ đối tác, nhà cung cấp hoặc nền tảng quảng cáo, cần kiểm tra thêm:
· Phương pháp thu thập
· Phạm vi mẫu
· Tần suất cập nhật
· Quy tắc loại trừ dữ liệu
· Cách xử lý dữ liệu thiếu
· Mô hình phân bổ hoặc ước tính được sử dụng
· Mức độ dữ liệu đã được tổng hợp
Nguồn không công bố phương pháp, không có tài liệu định nghĩa hoặc không thể giải thích quá trình biến đổi dữ liệu nên được xếp vào nhóm rủi ro cao. Khi đó, dữ liệu có thể được sử dụng để tham khảo nhưng không nên là căn cứ duy nhất cho quyết định quan trọng.
Kiểm tra độ chính xác của dữ liệu
Độ chính xác thể hiện mức độ giá trị trong hệ thống phù hợp với sự kiện hoặc trạng thái thực tế.
Có thể kiểm tra độ chính xác bằng ba phương pháp chính.
Đối chiếu với nguồn chuẩn
Một phần dữ liệu được so sánh với nguồn có độ xác thực cao hơn, chẳng hạn:
· Doanh thu trong nền tảng phân tích so với hệ thống giao dịch
· Số đơn hàng trong báo cáo chiến dịch so với hệ thống quản lý đơn hàng
· Thông tin khách hàng trong CRM so với hồ sơ đã được xác minh
· Số lượt đăng ký so với dữ liệu từ hệ thống xác nhận tài khoản
Tỷ lệ khớp có thể được tính theo công thức:
Tỷ lệ khớp = Số bản ghi khớp với nguồn chuẩn / Tổng số bản ghi được kiểm tra × 100%
Ví dụ, nếu 940 trong 1.000 giao dịch được đối chiếu có giá trị đúng, tỷ lệ khớp là 94%. Tuy nhiên, tỷ lệ này chỉ có ý nghĩa khi nguồn đối chiếu thực sự đáng tin và tiêu chí “khớp” đã được định nghĩa rõ.
Kiểm tra giá trị bất hợp lý
Dữ liệu cần được rà soát để phát hiện các giá trị không thể hoặc khó xảy ra, chẳng hạn:
· Chi phí quảng cáo âm
· Ngày chuyển đổi xảy ra trước ngày tiếp xúc
· Tỷ lệ chuyển đổi lớn hơn 100% do sai mẫu số
· Tuổi khách hàng ngoài phạm vi hợp lý
· Một người dùng phát sinh hàng nghìn phiên trong vài phút
· Giá trị đơn hàng cao bất thường so với phân phối lịch sử
Điểm bất thường không nhất thiết là dữ liệu sai. Đó có thể là khách hàng thật, chiến dịch đặc biệt hoặc biến động theo mùa. Vì vậy, cần xác minh nguyên nhân trước khi loại bỏ.
Kiểm tra logic giữa các trường
Các trường dữ liệu có quan hệ phải tuân theo cùng một logic. Ví dụ:
· Khách hàng có ngày mua đầu tiên phải có ít nhất một giao dịch
· Đơn hàng đã hủy không nên được tính đồng thời là doanh thu hoàn tất
· Tổng doanh thu theo sản phẩm phải phù hợp với tổng doanh thu theo đơn hàng sau khi điều chỉnh hoàn tiền
· Khách hàng được gắn trạng thái “mới” không nên có lịch sử mua trước thời điểm phân loại
Vi phạm logic thường cho thấy vấn đề nằm trong quy tắc xử lý hoặc tích hợp dữ liệu chứ không chỉ ở từng bản ghi riêng lẻ.
Đo lường tính đầy đủ của dữ liệu
Tính đầy đủ phản ánh tỷ lệ thông tin cần thiết thực sự hiện diện trong tập dữ liệu.
Công thức cơ bản là:
Tỷ lệ đầy đủ = Số giá trị hợp lệ đã ghi nhận / Tổng số giá trị cần ghi nhận × 100%
Cần đo riêng cho từng trường quan trọng thay vì chỉ tính một tỷ lệ chung. Một tập dữ liệu có thể đạt 98% đầy đủ về tổng thể nhưng lại thiếu 40% giá trị nguồn khách hàng. Khi đó, dữ liệu vẫn không đủ tin cậy để phân tích hiệu quả theo kênh.
Các trường nên được ưu tiên kiểm tra gồm:
· Mã khách hàng hoặc mã người dùng
· Thời gian phát sinh sự kiện
· Nguồn và chiến dịch
· Sản phẩm hoặc dịch vụ
· Giá trị giao dịch
· Trạng thái chuyển đổi
· Thông tin đồng ý sử dụng dữ liệu
· Các biến dùng để phân khúc
Cần phân biệt ba trường hợp:
· Giá trị thực sự không tồn tại
· Giá trị tồn tại nhưng hệ thống không thu thập
· Giá trị được thu thập nhưng mất trong quá trình truyền hoặc xử lý
Ba nguyên nhân này dẫn đến ba biện pháp khắc phục khác nhau. Điền giá trị mặc định có thể làm báo cáo trông đầy đủ hơn nhưng không làm dữ liệu đáng tin hơn.
Một ngưỡng đầy đủ không thể áp dụng cho mọi trường. Trường bắt buộc để tính doanh thu có thể cần mức bao phủ gần như tuyệt đối, trong khi một thuộc tính bổ sung phục vụ phân khúc có thể chấp nhận tỷ lệ thiếu cao hơn. Ngưỡng phải được xác định theo hậu quả của việc thiếu dữ liệu đối với kết luận.
Xác minh tính nhất quán giữa các hệ thống
Tính nhất quán thể hiện việc cùng một khái niệm được ghi nhận theo cùng định nghĩa, định dạng và quy tắc trong toàn bộ hệ thống.
Các sai lệch phổ biến gồm:
· Một hệ thống ghi doanh thu trước hoàn tiền, hệ thống khác ghi doanh thu sau hoàn tiền
· Nền tảng quảng cáo dùng múi giờ khác với hệ thống bán hàng
· CRM định nghĩa khách hàng mới theo ngày tạo hồ sơ, trong khi hệ thống giao dịch dùng ngày mua đầu tiên
· Các kênh dùng cửa sổ phân bổ khác nhau
· Tên chiến dịch, nguồn hoặc sản phẩm không tuân theo quy ước chung
· Một khách hàng có nhiều mã định danh không được hợp nhất
Có thể đo tỷ lệ nhất quán bằng cách chọn các bản ghi hoặc chỉ tiêu tương ứng giữa hai hệ thống:
Tỷ lệ nhất quán = Số giá trị thống nhất giữa các hệ thống / Tổng số giá trị được đối chiếu × 100%
Khi số liệu khác nhau, không nên mặc định một bên sai. Trước tiên cần kiểm tra:
· Định nghĩa chỉ tiêu
· Khoảng thời gian báo cáo
· Múi giờ
· Bộ lọc
· Trạng thái giao dịch
· Quy tắc phân bổ
· Độ trễ xử lý
· Cách xử lý hoàn tiền và hủy đơn
Hai hệ thống có thể cùng hoạt động đúng nhưng cho kết quả khác nhau vì đang đo hai phạm vi khác nhau. Độ tin cậy chỉ được thiết lập khi sự khác biệt có thể được giải thích và tái tạo.
Đánh giá tính cập nhật và độ trễ
Dữ liệu đáng tin cho quyết định hiện tại phải phản ánh trạng thái đủ gần với thời điểm ra quyết định.
Hai chỉ số cần phân biệt là:
· Độ mới của dữ liệu: Khoảng thời gian từ lần cập nhật gần nhất đến thời điểm sử dụng
· Độ trễ dữ liệu: Khoảng thời gian từ khi sự kiện xảy ra đến khi dữ liệu sẵn sàng để phân tích
Ví dụ, dữ liệu chiến dịch được cập nhật mỗi giờ nhưng giao dịch chỉ được đồng bộ sau 24 giờ vẫn có độ trễ đáng kể đối với phân tích doanh thu.
Mức độ cập nhật cần thiết phụ thuộc vào mục đích:
· Theo dõi ngân sách quảng cáo trong ngày cần dữ liệu gần thời gian thực
· Đánh giá xu hướng khách hàng theo tháng có thể chấp nhận độ trễ dài hơn
· Báo cáo tài chính hoặc lợi nhuận cần chờ dữ liệu hoàn tiền, chi phí và đối soát hoàn chỉnh
Dữ liệu nhanh hơn chưa chắc đáng tin hơn. Một báo cáo sớm có thể thiếu chuyển đổi xảy ra muộn, giao dịch ngoại tuyến hoặc điều chỉnh hoàn tiền. Vì vậy, cần xác định thời điểm dữ liệu được xem là đủ ổn định trước khi kết luận.
Kiểm tra tính duy nhất và quản trị định danh
Dữ liệu trùng lặp làm tăng giả tạo số lượng khách hàng, lượt chuyển đổi hoặc doanh thu.
Tỷ lệ trùng lặp có thể được tính như sau:
Tỷ lệ trùng lặp = Số bản ghi trùng / Tổng số bản ghi × 100%
Việc xác định bản ghi trùng không nên chỉ dựa trên một trường. Hai hồ sơ có cùng email có thể thuộc cùng một người, nhưng một email dùng chung cũng có thể đại diện cho nhiều người. Ngược lại, một khách hàng có thể sử dụng nhiều email, thiết bị hoặc số điện thoại.
Cần xây dựng quy tắc định danh dựa trên mức độ chắc chắn:
· Khớp chính xác bằng mã khách hàng nội bộ
· Khớp bằng thông tin đã xác minh
· Khớp xác suất dựa trên nhiều thuộc tính
· Không hợp nhất khi mức độ chắc chắn không đủ
Hợp nhất quá ít làm tăng số khách hàng giả tạo. Hợp nhất quá mạnh có thể gộp nhầm nhiều người thành một hồ sơ. Do đó, quản trị định danh luôn có sự đánh đổi giữa độ bao phủ và nguy cơ ghép sai.
Đánh giá tính đại diện của dữ liệu
Tính đại diện trả lời câu hỏi: dữ liệu đang mô tả đúng nhóm khách hàng cần nghiên cứu hay chỉ mô tả nhóm có thể quan sát được?
Dữ liệu có thể thiếu đại diện khi:
· Chỉ ghi nhận người dùng đã đồng ý theo dõi
· Chỉ bao gồm khách hàng trực tuyến
· Bỏ sót giao dịch tại cửa hàng
· Khảo sát chủ yếu thu hút người có trải nghiệm đặc biệt tích cực hoặc tiêu cực
· Mẫu tập trung vào một khu vực, thiết bị hoặc nhóm tuổi
· Dữ liệu chỉ phản ánh khách hàng đã chuyển đổi, không phản ánh người đã rời bỏ hành trình
Để đánh giá, cần so sánh cơ cấu mẫu với tổng thể mục tiêu theo các biến có liên quan, chẳng hạn:
· Khu vực
· Độ tuổi
· Loại khách hàng
· Kênh mua
· Nhóm sản phẩm
· Giá trị giao dịch
· Thiết bị
· Giai đoạn trong hành trình khách hàng
Ví dụ, nếu thiết bị di động chiếm 70% khách truy cập nhưng chỉ chiếm 35% mẫu khảo sát, kết quả khảo sát có nguy cơ phản ánh quá mức trải nghiệm của người dùng máy tính.
Cỡ mẫu lớn không tự động bảo đảm tính đại diện. Một triệu bản ghi được thu thập bằng cơ chế thiên lệch vẫn có thể dẫn đến kết luận sai về tổng thể.
Xác định dữ liệu có phù hợp với mục tiêu phân tích hay không
Độ phù hợp là điều kiện thường bị bỏ qua khi doanh nghiệp tập trung quá nhiều vào việc làm sạch dữ liệu.
Trước khi phân tích, cần xác định rõ:
· Đối tượng cần đánh giá
· Chỉ tiêu cần đo
· Khoảng thời gian
· Đơn vị phân tích
· Kênh và điểm tiếp xúc liên quan
· Mức độ chi tiết cần thiết
· Quyết định sẽ được đưa ra từ kết quả
Ví dụ, dữ liệu lượt nhấp có thể phù hợp để đánh giá mức độ phản hồi với quảng cáo nhưng không đủ để kết luận chiến dịch tạo ra lợi nhuận. Dữ liệu doanh thu có thể cho biết giá trị bán hàng nhưng chưa đủ để đo hiệu quả nếu thiếu chi phí, hoàn tiền và biên lợi nhuận.
Một tập dữ liệu đáng tin cho câu hỏi này có thể không đáng tin cho câu hỏi khác. Vì vậy, đánh giá chất lượng phải gắn với trường hợp sử dụng cụ thể thay vì cấp chứng nhận chung cho toàn bộ cơ sở dữ liệu.
Kiểm tra sai lệch trong quá trình thu thập và đo lường
Sai lệch là lỗi có tính hệ thống khiến dữ liệu nghiêng về một kết quả nhất định. Khác với lỗi ngẫu nhiên, sai lệch không nhất thiết giảm khi tăng số lượng dữ liệu.
Các dạng sai lệch thường gặp gồm:
Sai lệch lựa chọn
Nhóm xuất hiện trong dữ liệu khác có hệ thống so với nhóm cần nghiên cứu. Ví dụ, khảo sát tự nguyện thường thu hút những người có động lực phản hồi cao hơn mức trung bình.
Sai lệch đo lường
Công cụ hoặc định nghĩa làm sự kiện bị ghi nhận không đúng. Ví dụ, tải lại trang khiến sự kiện đăng ký được gửi nhiều lần.
Sai lệch sống sót
Phân tích chỉ tập trung vào khách hàng còn hoạt động mà bỏ qua những người đã rời bỏ, từ đó đánh giá quá tích cực về trải nghiệm hoặc giá trị vòng đời.
Sai lệch phân bổ
Nhiều nền tảng cùng nhận công cho một chuyển đổi hoặc mô hình phân bổ ưu tiên quá mức một điểm tiếp xúc. Khi cộng báo cáo từ nhiều nền tảng, tổng chuyển đổi được ghi nhận có thể vượt quá số chuyển đổi thực tế.
Sai lệch do dữ liệu thiếu
Dữ liệu không thiếu ngẫu nhiên. Chẳng hạn, một nhóm khách hàng có xu hướng từ chối theo dõi nhiều hơn nhóm khác, khiến dữ liệu quan sát được không đại diện cho toàn bộ khách hàng.
Phát hiện sai lệch đòi hỏi so sánh nhóm có dữ liệu với nhóm không có dữ liệu, kiểm tra thay đổi sau khi điều chỉnh phương pháp và phân tích liệu kết luận có ổn định dưới các giả định khác nhau hay không.
Đánh giá độ ổn định và khả năng tái lập kết quả
Dữ liệu đáng tin phải tạo ra kết quả tương đối ổn định khi cùng quy trình được thực hiện lại trong điều kiện tương đương.
Có thể kiểm tra bằng cách:
· Chạy lại cùng truy vấn ở cùng phiên bản dữ liệu
· So sánh kết quả giữa các khoảng thời gian tương đương
· Chia mẫu thành nhiều nhóm và kiểm tra độ nhất quán
· Thay đổi hợp lý một số giả định rồi đánh giá độ nhạy của kết luận
· Đối chiếu kết quả giữa các công cụ hoặc nhóm phân tích
Nếu một thay đổi nhỏ trong bộ lọc làm kết luận đảo ngược hoàn toàn, kết quả có thể đang phụ thuộc quá mạnh vào một nhóm nhỏ, điểm bất thường hoặc quy tắc phân loại.
Tái lập không có nghĩa là số liệu phải giống nhau trong mọi thời điểm. Thị trường và hành vi khách hàng có thể thay đổi. Yêu cầu quan trọng là quy trình phải tạo cùng kết quả khi dùng cùng dữ liệu, cùng định nghĩa và cùng phương pháp.
Sử dụng bảng điểm để lượng hóa mức độ tin cậy
Do không có một ngưỡng chung phù hợp cho mọi doanh nghiệp, có thể xây dựng bảng điểm nội bộ để chuẩn hóa quyết định sử dụng dữ liệu.
Mỗi tiêu chí có thể được chấm theo thang 0–2:
· 0 điểm: Không xác minh được hoặc có lỗi nghiêm trọng
· 1 điểm: Đáp ứng một phần, còn hạn chế cần kiểm soát
· 2 điểm: Đáp ứng đầy đủ trong phạm vi sử dụng
Các tiêu chí gồm:
1. Nguồn gốc và khả năng truy vết
2. Độ chính xác
3. Tính đầy đủ
4. Tính nhất quán
5. Tính cập nhật
6. Tính duy nhất
7. Tính đại diện
8. Độ phù hợp với mục tiêu
9. Khả năng kiểm soát sai lệch
10. Khả năng tái lập
Nếu các tiêu chí có tầm quan trọng khác nhau, có thể tính điểm có trọng số:
Điểm tin cậy = Tổng điểm tiêu chí sau khi nhân trọng số / Tổng điểm tối đa sau khi nhân trọng số × 100
Một cách phân loại nội bộ có thể là:
· Từ 85% trở lên: Có thể dùng cho phân tích và quyết định trong phạm vi đã kiểm tra
· Từ 70% đến dưới 85%: Có thể sử dụng nhưng phải công bố hạn chế
· Từ 50% đến dưới 70%: Chỉ nên dùng để thăm dò hoặc định hướng
· Dưới 50%: Chưa nên dùng làm căn cứ ra quyết định
Các mức trên là quy ước quản trị, không phải tiêu chuẩn phổ quát. Doanh nghiệp cần điều chỉnh theo mức độ rủi ro. Dữ liệu phục vụ báo cáo tài chính, phân bổ ngân sách lớn hoặc quyết định liên quan đến khách hàng có thể cần ngưỡng nghiêm ngặt hơn dữ liệu dùng để khám phá giả thuyết.
Ngoài điểm tổng, cần đặt điều kiện loại trừ. Chẳng hạn, dữ liệu không nên được phê duyệt dù tổng điểm cao nếu thiếu nguồn gốc, sai doanh thu trọng yếu hoặc không xác định được đối tượng đo lường.
Quy trình kiểm tra dữ liệu trước khi phân tích
Một quy trình kiểm tra thực tế có thể được triển khai theo sáu bước.
Bước 1: Xác định câu hỏi và phạm vi sử dụng
Ghi rõ dữ liệu sẽ hỗ trợ quyết định nào, đối tượng nào, thời gian nào và sai số có thể chấp nhận đến đâu.
Bước 2: Lập danh mục nguồn dữ liệu
Liệt kê hệ thống nguồn, chủ sở hữu, phương pháp thu thập, lịch cập nhật, quy tắc xử lý và các bước tích hợp.
Bước 3: Lập hồ sơ chất lượng dữ liệu
Đo tỷ lệ thiếu, trùng lặp, giá trị bất thường, phân phối, định dạng, phạm vi thời gian và mức độ khớp giữa các trường.
Bước 4: Đối chiếu với nguồn chuẩn
Chọn mẫu để kiểm tra với giao dịch, hồ sơ đã xác minh hoặc hệ thống vận hành có độ tin cậy cao hơn.
Bước 5: Kiểm tra sai lệch và độ đại diện
So sánh dữ liệu quan sát được với tổng thể mục tiêu, đồng thời xác định nhóm nào có nguy cơ bị bỏ sót hoặc ghi nhận quá mức.
Bước 6: Ghi nhận kết luận và giới hạn sử dụng
Mỗi tập dữ liệu nên có hồ sơ nêu rõ:
· Mức độ tin cậy
· Phạm vi được phép sử dụng
· Những hạn chế đã biết
· Ngày kiểm tra gần nhất
· Người chịu trách nhiệm
· Điều kiện cần kiểm tra lại
Việc kiểm tra không nên chỉ thực hiện một lần. Khi nguồn, định nghĩa, công cụ theo dõi, mô hình phân bổ hoặc quy trình tích hợp thay đổi, kết quả đánh giá trước đó có thể không còn hiệu lực.
Những dấu hiệu cho thấy dữ liệu chưa đủ tin cậy
Dữ liệu cần được xem xét lại khi xuất hiện một hoặc nhiều dấu hiệu sau:
· Không xác định được nguồn hoặc phương pháp thu thập
· Cùng một chỉ tiêu có nhiều định nghĩa
· Tổng số chuyển đổi từ các kênh vượt xa số chuyển đổi thực tế
· Báo cáo thay đổi lớn sau mỗi lần tải lại mà không có nguyên nhân rõ ràng
· Nhiều trường quan trọng bị thiếu
· Tỷ lệ trùng lặp tăng bất thường
· Cơ cấu mẫu khác đáng kể so với khách hàng mục tiêu
· Các hệ thống không thống nhất về thời gian, doanh thu hoặc trạng thái giao dịch
· Kết luận phụ thuộc vào một nhóm rất nhỏ
· Không thể chạy lại để thu được cùng kết quả
· Không có tài liệu về các bước làm sạch và biến đổi
· Người phân tích không thể nêu giới hạn của dữ liệu
Không phải mọi lỗi đều khiến toàn bộ dữ liệu vô dụng. Cần xác định lỗi ảnh hưởng đến chỉ tiêu nào, mức độ nghiêm trọng ra sao và có thể kiểm soát bằng bộ lọc, hiệu chỉnh hoặc giới hạn diễn giải hay không.
Phân biệt dữ liệu sạch với dữ liệu đáng tin cậy
Dữ liệu sạch thường có định dạng đúng, ít giá trị thiếu, ít bản ghi trùng và không chứa lỗi cú pháp rõ ràng. Dữ liệu đáng tin cậy cần nhiều hơn thế.
Một tập dữ liệu có thể rất sạch nhưng vẫn không đáng tin nếu:
· Thu thập sai đối tượng
· Dùng định nghĩa không phù hợp
· Thiếu một kênh quan trọng
· Chịu sai lệch lựa chọn
· Không đại diện cho tổng thể
· Không phù hợp với câu hỏi phân tích
Ngược lại, một tập dữ liệu có một số giá trị thiếu vẫn có thể được sử dụng nếu phạm vi thiếu được hiểu rõ, không làm thay đổi kết luận và được công bố minh bạch.
Vì vậy, làm sạch dữ liệu là một bước kỹ thuật. Đánh giá độ tin cậy là một quá trình kiểm chứng toàn diện bao gồm nguồn, phương pháp, chất lượng, phạm vi và rủi ro diễn giải.
Độ tin cậy của dữ liệu Marketing phải được đánh giá dựa trên cả chất lượng kỹ thuật lẫn mức độ phù hợp với quyết định. Những tiêu chí cốt lõi gồm nguồn gốc, độ chính xác, tính đầy đủ, nhất quán, cập nhật, duy nhất, đại diện, khả năng kiểm soát sai lệch và khả năng tái lập.
Không nên kết luận dữ liệu “đáng tin” chỉ dựa trên một tỷ lệ tổng hợp. Điểm đánh giá cần đi kèm phạm vi sử dụng, giới hạn đã biết và các điều kiện loại trừ. Cách tiếp cận này giúp doanh nghiệp tránh hai sai lầm đối lập: loại bỏ dữ liệu vẫn còn giá trị vì một số khiếm khuyết nhỏ, hoặc sử dụng dữ liệu có vẻ hoàn chỉnh để đưa ra quyết định vượt quá khả năng chứng minh của nó.
Hỏi đáp về độ tin cậy dữ liệu marketing
Có tỷ lệ chính xác tối thiểu nào cho dữ liệu Marketing không?
Không có một tỷ lệ áp dụng cho mọi loại dữ liệu và mọi quyết định. Ngưỡng cần được xác định theo mức độ ảnh hưởng của sai số. Dữ liệu dùng để tham khảo xu hướng có thể chấp nhận sai lệch cao hơn dữ liệu dùng để phân bổ ngân sách lớn hoặc xác định doanh thu.
Dữ liệu từ Google Analytics, CRM hoặc nền tảng quảng cáo có mặc nhiên đáng tin không?
Không. Mỗi hệ thống ghi nhận dữ liệu theo định nghĩa, phạm vi và cơ chế xử lý riêng. Cần kiểm tra cấu hình theo dõi, mô hình phân bổ, độ trễ, khả năng nhận diện người dùng và mức độ khớp với dữ liệu giao dịch thực tế.
Cỡ mẫu lớn có làm dữ liệu đáng tin hơn không?
Cỡ mẫu lớn có thể giảm biến động ngẫu nhiên nhưng không loại bỏ sai lệch có hệ thống. Nếu mẫu được thu thập sai đối tượng hoặc bỏ sót một nhóm quan trọng, tăng số lượng bản ghi không khắc phục được vấn đề đại diện.
Nên xử lý thế nào khi hai hệ thống cho số liệu khác nhau?
Trước tiên cần thống nhất định nghĩa chỉ tiêu, khoảng thời gian, múi giờ, bộ lọc, trạng thái giao dịch và quy tắc phân bổ. Chỉ sau khi các điều kiện này giống nhau mới có thể xác định sự khác biệt là lỗi dữ liệu hay khác biệt hợp lý về phương pháp đo.
Bao lâu nên đánh giá lại độ tin cậy của dữ liệu?
Nên đánh giá lại khi có thay đổi về nguồn dữ liệu, công cụ theo dõi, định nghĩa chỉ tiêu, quy trình tích hợp, chính sách quyền riêng tư hoặc mô hình phân bổ. Với dữ liệu quan trọng, doanh nghiệp cũng nên thiết lập lịch kiểm tra định kỳ thay vì chờ đến khi báo cáo xuất hiện sai lệch.

GỬI Ý KIẾN BÌNH LUẬN
